“Kunt u er een exacte waarde aan hangen?” Het is een vraag die journalisten graag stellen aan wetenschappers. U zegt dan wel dat een nieuw medicijn ‘een grotere kans’ op genezing geeft, of dat microplastics allergieën kunnen ‘verergeren’, maar wat houdt ‘groter’ en ‘verergerd’ precies in? Een percentage is een mooi begin, maar vaak niet voldoende. Als een peperduur medicijn twintig procent meer kans op genezing geeft dan bestaande middelen, klinkt dat geweldig. Maar als met de bestaande middelen een op de honderd patiënten geneest, moeten we toch even goed nadenken of een kans van 1,2 procent al dat geld wel waard is. En over hoeveel patiënten hebben we dan in de praktijk?
Ook ik heb die vraag vast al honderden keren gesteld, maar ik ben bepaald geen cijferfetisjist. Sterker nog, veel getallen maken mij extreem wantrouwig. Dat is met name het geval als het gaat om informatie die met vragenlijsten is verzameld. En laat nou bijna alle openbare informatie over wat u en ik vinden, denken, willen en doen – het type informatie waar zowel politici als marketeers dol op zijn – gebaseerd zijn op vragenlijsten.
Een voorbeeld. Volgens de meest recente Burgermonitor van onze hoofdstad geven Amsterdammers de ambtelijke dienstverlening gemiddeld een 6,9 – dat is 0,4 procentpunt meer dan vijf jaar geleden. Goed nieuws? Nou, als Amsterdammer weet ik toevallig hoe de gemeente deze informatie verzamelt: eens in de zoveel tijd valt er een brief op mijn mat met het verzoek om een QR-code te scannen en een online vragenlijst in te vullen. Bij mij blijft die brief meestal een paar weken rondslingeren tot hij alsnog bij het oud papier eindigt. Ik vraag me altijd af wie wél de moeite neemt om naar een website te gaan en cijfers te geven aan gemeentelijke contactmomenten. Wat zijn dat voor bijzondere mensen en waarin verschillen ze van mij en andere enquêteweigeraars?
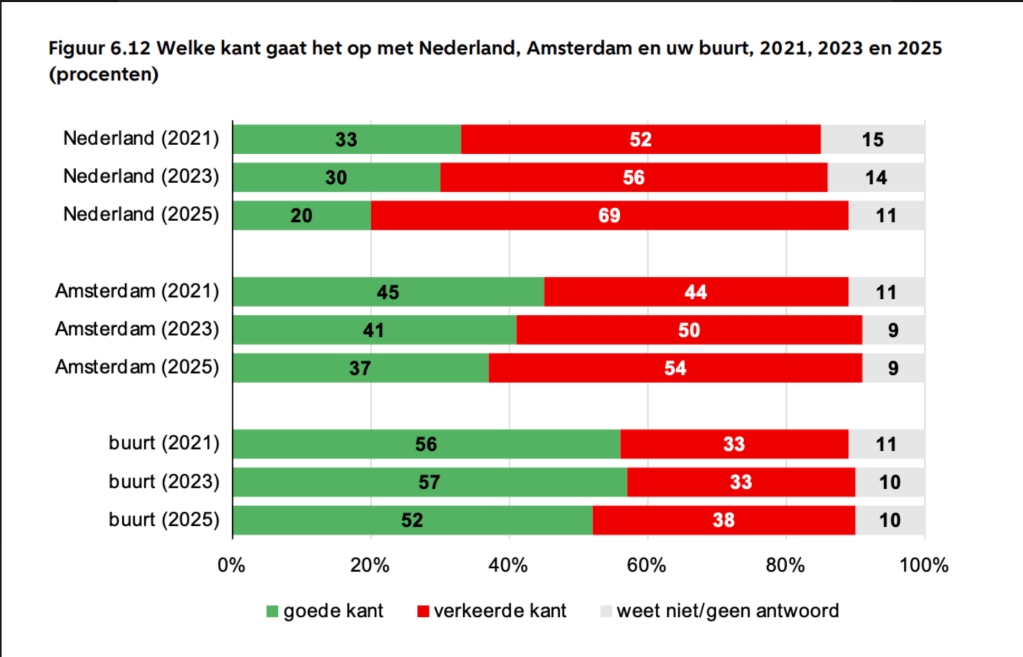
Niet alleen zijn zulke studies vaak niet representatief, maar je kunt je ook afvragen wat de vragenlijsten nou eigenlijk meten. Zo lees ik op pagina 53 van dezelfde monitor onder de kop ‘Hoe gaat het in Amsterdam?’, dat ruim de helft van de bewoners vindt dat het ‘de slechte kant’ op gaat. De andere opties waren: ‘goede kant’ of ‘weet niet’. Tja. Wat de respondenten verstaan onder ‘goede kant’ of ‘slechte kant’? Niemand die het weet.
Virginia Dignum, hoogleraar Computer Science van de Universiteit van Umeå (Zweden), waarschuwt in haar boek The AI Paradox voor ‘datificatie’ door een al te achteloze inzet van AI. Data, zegt zij in een gesprek dat ik met haar had voor Nemo Kennislink, zijn bepaald geen natuurlijk fenomeen: wij maken die data. Wij bepalen immers wat we willen weten en verzinnen welke data we daarvoor moeten verzamelen, eventueel met behulp van sensoren. Sensoren kunnen van alles meten: temperatuur, licht, hartslag, geluid, ga zo maar door. Maar zaken als geur, stemming, of motivatie ontsnappen aan de sensor en dus ook aan de nagemaakte werkelijkheid die we creëren met onze dataverzamelingen. Die namaakrealiteit is contextloos en gaat altijd alleen over het resultaat. We kunnen wel meten hoeveel kopjes koffie er vandaag zijn gedronken op het station van Utrecht, maar niet wat mensen tot die keuze heeft gebracht.
‘Meten is weten’ is niet alleen een cliché, het is ook nog eens een zeer misleidende overtuiging. De meeste dingen zijn helemaal niet te meten, laat staan uit te drukken in harde getallen. Zowel wetenschappers als journalisten mogen daar wel wat vaker bij stilstaan.
 Enith Vlooswijk
